Osoby, które w ostatnich tygodniach planowały rozbudowę komputera o dodatkową pamięć RAM lub szybszy dysk SSD, mogły przeżyć niemałe zaskoczenie. Ceny komponentów pamięci RAM i dysków wyraźnie poszły w górę, a wszystko wskazuje na to, że nie jest to chwilowa korekta, lecz efekt głębszych zmi...

Zdaniem 45% respondentów przeprowadzonego przez IDC badania to nie ataki ransomware, lecz zachowanie kontroli nad infrastrukturą (w tym szyfrowaniem i utrzymaniem suwerenności danych) mogą w 2026 roku stać się największym wyzwaniem dla zapewnienia bezpieczeństwa i prywatności informacji. Potwierdzają to wyniki a...

Microsoft Azure to potężna platforma do budowania i uruchamiania aplikacji cloud-native. Jednak, jak potwierdzi każdy doświadczony architekt chmurowy lub inżynier SRE - monitorowanie środowiska Azure może przypominać próbę okiełznania chaosu. Setki metryk, logów i alertów napływających z maszyn wir...
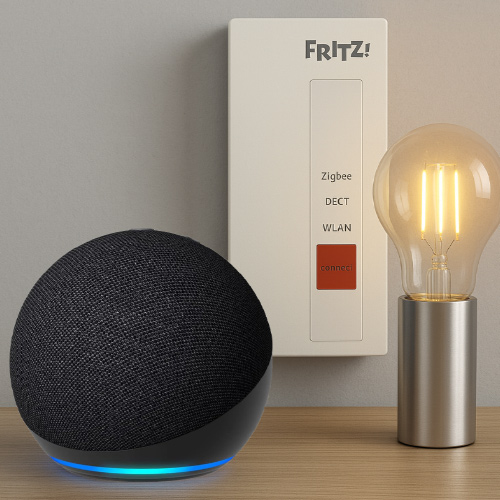
W dobie szybko rozwijających się technologii Smart Home coraz więcej użytkowników poszukuje rozwiązań, które pozwolą na wygodne i centralne zarządzanie inteligentnymi urządzeniami w domu. Połączenie bramki FRITZ!Smart Gateway z głośnikami Amazon Echo i asystentem Alexa to prosty sposób na wprowadze...

Jak wynika z opublikowanego przez Fortinet dokumentu „2023 Cloud Security Report”, w chmurze publicznej znajduje się już ponad połowa danych prawie 40% ankietowanych przedsiębiorstw. W ciągu najbliższych 12-18 miesięcy odsetek tych firm zwiększy się do 58%, co spowoduje, że wyzwań związanych z zabezpieczani...

Rozwój modeli AI zwiększa ich zdolność do rozwiązywania złożonych problemów i lepszego rozumienia kontekstu, ale może jednocześnie wpływać na zmianę profilu ryzyka związanego z ich wykorzystaniem - wynika z kwietniowej analizy F5 Labs. Dane sugerują, że modele wyposażone w mechanizmy wieloetapowego wniosk...
 Huawei zaprezentował nową architekturę infrastruktury AI, której ważnym elementem jest UnifiedBus - technologia mająca pozwolić na skalowanie systemów obliczeniowych od pojedynczych szaf aż po klastry obejmujące nawet milion NPU. Rozwiązanie można postrzegać jako element szerszej strategii Huawei mającej stworzyć alternatywę dla infrastruktury na potrzeby sztucznej inteligencji rozwijanej przez NVIDIA.
Wraz ze wzrostem liczby akceleratorów coraz większym problemem staje się komunikacja między nimi. Sama liczba NPU czy GPU nie wystarczy, jeśli wymiana danych zaczyna ograniczać wydajność całego klastra.
UnifiedBus ma obsługiwać komunikację pomiędzy różnymi elementami infrastruktury: NPU, CPU, pamięcią, SSD, kartami sieciowymi i przełącznikami. Huawei deklaruje połączenie ponad dziesięciu dotychczas stosowanych protokołów w jeden mechanizm komunikacji.
Huawei mówi o wzroście przepustowości ze 100 GB/s do poziomu TB/s oraz skróceniu średniego RTT z 7 do 2 mikrosekund.
Ważną częścią nowej koncepcji jest zunifikowane adresowanie pamięci i bezpośrednia komunikacja między poszczególnymi zasobami. Huawei określa całą architekturę mianem Peerium Computing Architecture, a UnifiedBus pełni w niej kluczową rolę, pozwalając traktować nawet milion procesorów jak jeden system obliczeniowy.
Huawei UnifiedBus warto przy tym zestawić z rozwiązaniami NVIDIA, która rozwija ten obszar przede wszystkim za pomocą NVLink i NVSwitch, technologii pozwalających łączyć GPU w duże domeny obliczeniowe, jednocześnie zapewniających na szybką komunikację między akceleratorami. W najnowszej generacji NVLink 6 NVIDIA deklaruje do 3,6 TB/s dwukierunkowej przepustowości na GPU, a architektura Vera Rubin NVL72 obejmuje 72 GPU w pojedynczym racku. Ponadto NVIDIA zapowiada rozwój domen NVLink do 1152 GPU.
Huawei podchodzi do problemu szerzej. UnifiedBus ma obsługiwać nie tylko komunikację między akceleratorami, lecz także połączenia z CPU, pamięcią, pamięcią masową i pozostałymi elementami infrastruktury, docelowo prowadząc do architektury, w której bardzo duża liczba procesorów może być traktowana jako jeden system.
Na dzień dzisiejszy nie można uznać architektury Huawei za technologicznego odpowiednika NVIDIA, gdyż amerykański gigant dysponuje znacznie dojrzalszym i szeroko wdrożonym ekosystemem obejmującym sprzęt, interconnect, sieć oraz oprogramowanie, w tym CUDA i biblioteki przeznaczone do pracy z rozproszonymi modelami AI. Sama NVIDIA podkreśla, że wydajność dużych systemów zależy nie tylko od przepustowości interconnectu, ale również od oprogramowania, topologii, zarządzania ruchem i odporności całej infrastruktury.
Huawei zaprezentował również konkretne komponenty wykorzystujące UnifiedBus. LinkBlade odpowiadający za komunikację wewnątrz szafy, LinkDevice za połączenia pomiędzy szafami, natomiast przełącznik UnifiedBus UBG za komunikację pomiędzy większymi klastrami.
Według zapewnień Huawei, LinkDevice oferuje 176 portów o przepustowości 1,6 Tbit/s każdy, a UBG ma pozwalać na budowę bardzo dużych systemów. Producent deklaruje możliwość skalowania architektury do 512 tys. NPU, a przy zastosowaniu odpowiedniej topologii, nawet do miliona NPU.
Huawei zaprezentował również rozwiązania dla SuperPoD, w tym systemy Atlas wyposażone w akceleratory Ascend. Firma wskazuje na możliwość budowania konfiguracji obejmujących tysiące NPU, które następnie mogą być łączone w jeszcze większe klastry.
Trzeba przy tym pamiętać, że milion NPU to możliwość architektury, podana przez Huawei, a nie wynik niezależnego benchmarku.
Wraz z prezentacją UnifiedBus Huawei pokazał, że wychodzi znacznie dalej poza kolejne generacje akceleratorów Ascend. Firma buduje własny stos obejmujący procesory, pamięć, interconnect, przełączniki i oprogramowanie.
Podobny kierunek obrała NVIDIA, która również buduje kompletne platformy AI obejmujące GPU, NVLink, sieć, systemy rackowe i oprogramowanie. Różnica polega na tym, że NVIDIA ma za sobą wiele lat rozwoju i wdrażania tego ekosystemu, podczas gdy Huawei dopiero rozwija własną architekturę na tak dużą skalę.
Na razie najważniejsze pozostaje to, jak UnifiedBus będzie zachowywał się w rzeczywistych wdrożeniach. Dopiero wtedy będzie można ocenić, na ile deklaracje Huawei przekładają się na praktyczną wydajność dużych klastrów AI zbudowanych w oparciu o prezentowaną technologię.
Źródło: Huawei, Silicon UK, opracowanie własne