Zdaniem 45% respondentów przeprowadzonego przez IDC badania to nie ataki ransomware, lecz zachowanie kontroli nad infrastrukturą (w tym szyfrowaniem i utrzymaniem suwerenności danych) mogą w 2026 roku stać się największym wyzwaniem dla zapewnienia bezpieczeństwa i prywatności informacji. Potwierdzają to wyniki a...

Microsoft Azure to potężna platforma do budowania i uruchamiania aplikacji cloud-native. Jednak, jak potwierdzi każdy doświadczony architekt chmurowy lub inżynier SRE - monitorowanie środowiska Azure może przypominać próbę okiełznania chaosu. Setki metryk, logów i alertów napływających z maszyn wir...
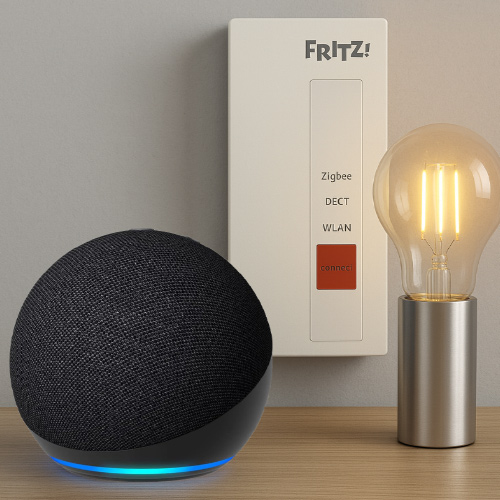
W dobie szybko rozwijających się technologii Smart Home coraz więcej użytkowników poszukuje rozwiązań, które pozwolą na wygodne i centralne zarządzanie inteligentnymi urządzeniami w domu. Połączenie bramki FRITZ!Smart Gateway z głośnikami Amazon Echo i asystentem Alexa to prosty sposób na wprowadze...

Jak wynika z opublikowanego przez Fortinet dokumentu „2023 Cloud Security Report”, w chmurze publicznej znajduje się już ponad połowa danych prawie 40% ankietowanych przedsiębiorstw. W ciągu najbliższych 12-18 miesięcy odsetek tych firm zwiększy się do 58%, co spowoduje, że wyzwań związanych z zabezpieczani...

Osoby, które w ostatnich tygodniach planowały rozbudowę komputera o dodatkową pamięć RAM lub szybszy dysk SSD, mogły przeżyć niemałe zaskoczenie. Ceny komponentów pamięci RAM i dysków wyraźnie poszły w górę, a wszystko wskazuje na to, że nie jest to chwilowa korekta, lecz efekt głębszych zmi...

Rozwój modeli AI zwiększa ich zdolność do rozwiązywania złożonych problemów i lepszego rozumienia kontekstu, ale może jednocześnie wpływać na zmianę profilu ryzyka związanego z ich wykorzystaniem - wynika z kwietniowej analizy F5 Labs. Dane sugerują, że modele wyposażone w mechanizmy wieloetapowego wniosk...
 W ośrodkach danych i prywatnych chmurach decyzja o hiperwizorze przestaje być „wyborem marki” - staje się decyzją o mocy obliczeniowej, przestrzeni dyskowej, sieci i budżecie na lata. Coraz więcej zespołów IT porównuje więc klasyczny stos VMware z modelem KVM bez opłat za każdą maszynę wirtualną.
Data center żyje metrykami: zajętość szaf rack, PUE, opóźnienia storage, przepustowość sieci leaf-spine. Wirtualizacja albo wzmacnia te metryki, albo je marnuje. Gdy licencja hiperwizora rośnie proporcjonalnie do rdzeni albo socketów, koszt platformy zaczyna konkurować z kosztem prądu i chłodzenia. To sygnał, by przeprojektować warstwę compute - nie tylko „odnowić umowę”. W tym kontekście proxmox dla firm oznacza kontrolę nad klastrem bez licencji hiperwizora per VM.
W dojrzałym DC maszyny nie powinny wisieć na pojedynczym hoście „bo tak wyszło historycznie”. Klaster z żywą migracją, regułami HA i wspólnym storage pozwala traktować serwery jak wymienialne bloki. Proxmox VE buduje taki model na KVM i LXC: maszyny pełne obok kontenerów, jeden panel i jeden model uprawnień. Zespoły z ESXi mapują datastore, vSwitch i DRS na mosty, VLAN-y, Ceph lub ZFS oraz reguły affinity.
Start to inwentaryzacja: ile vCPU realnie pracuje, ile pamięci jest „zarezerwowane na zapas”, które dyski są lokalne, a które na SAN/NAS. Często widać nadmiar vCPU i RAM - rzędu jednej trzeciej albo więcej - z ostrożności, nie z pomiaru. Migracja to moment, by zmierzyć ten nadmiar i zaprojektować pojemność pod faktyczny ruch, nie pod stare szablony.
Wirtualizacja bez przemyślanego I/O to tylko ładny panel. W DC trzeba rozstrzygnąć: lokalne NVMe z replikacją, współdzielony Ceph, iSCSI do macierzy czy hybryda. Każda opcja ma inny profil awarii i inne okno utrzymania. Przed falą produkcyjną zmierzcie latencję i IOPS na obciążeniu zbliżonym do produkcji - syntetyczny benchmark bez aplikacji biznesowej kłamie.
Backup w DC to osobna warstwa, nie „opcja w hiperwizorze”. Snapshot nie zastępuje kopii poza siedzibą. Test odtworzenia na chłodnym ośrodku powinien być kryterium odbioru klastra, zanim przeniesiecie krytyczne bazy. Ransomware pyta, czy umiecie odtworzyć dane poza zainfekowaną siecią.
Chmura prywatna w racku wymaga tej samej dyscypliny co publiczna: segmentacja, adresacja, polityki. Na Proxmox mosty Linux i VLAN-y wystarczają w wielu firmach; większe środowiska sięgają po SDN Fabrics i EVPN/VXLAN. Lepiej narysować topologię docelową, niż kopiować bałagan jeden do jednego.
DNS, VIP i certyfikaty to ciche zabójce przełączenia. Gdy usługi mają VIP na load balancerze, kolejność jest taka: najpierw sieć i monitoring, potem maszyny aplikacyjne, na końcu te z twardymi zależnościami czasowymi. Krótkie okno (rzędu minut, przy dobrym przygotowaniu nawet około dwóch na pojedynczą VM) jest osiągalne.
Odpowiedzialne wdrożenia proxmox w ośrodku danych nie zaczynają się od przeniesienia ERP. Zaczynają się od pilotażu: kilka reprezentatywnych maszyn, pomiar I/O, test HA, test odtworzenia i szkolenie operatorów. Potem fale według krytyczności i zależności. Wycofanie musi być zapisane, nie „domyślne w głowie admina”.
Ustalcie role: kto zatwierdza change, kto pilnuje storage, kto sieć, kto aplikacje. Bez tej mapy klaster staje się wspólną własnością, czyli niczyją. Po każdej fali aktualizujcie scenariusze operacyjne i dokumentację pojemności - drift między node’ami wychodzi w najmniej wygodnym momencie.
Koszty w DC to więcej niż subskrypcja hiperwizora: wsparcie, szkolenia, backup, czas ludzi i ryzyko uzależnienia od dostawcy. Opłata za platformę per gęstość VM bywa wyższa niż sprzęt i energia razem. Dlatego zespoły wracają do proxmox ve jako fundamentu prywatnej chmury: otwarte API, przewidywalne koszty i kompetencje wewnątrz.
Nie oznacza to, że „otwarte oprogramowanie = zero kosztów”. Budżet idzie na ludzi, storage i bezpieczeństwo - elementy, które i tak musicie mieć - a nie na prawo do kolejnej maszyny. W horyzoncie trzech-pięciu lat różnica bywa rzędu wielkości, zwłaszcza po skokach cen licencji.
Klaster w DC musi mieć 2FA do panelu, integrację z katalogiem, segmentację ruchu zarządzającego i osobne VLAN-y dla magazynu oraz migracji na żywo. Logi powinny trafiać do SIEM, a alerty HA i dyskowe - do dyżuru, nie do skrzynki „info@”. Po migracji sprawdźcie, czy stare hosty ESXi nie zostały jako ciche furtki „na wszelki wypadek”.
Firmware, kernel i QEMU wymagają okien serwisowych tak samo jak wcześniej. Procedura może być Wasza i wersjonowana w repozytorium, a nie zamknięta u vendora.
Wirtualizacja w data center to projekt pojemności, sieci i operacji, nie wymiana logo na panelu. Ułóżcie warstwy: compute, storage, sieć, backup, tożsamość. Zmierzcie, zanim przeniesiecie, wdróżcie falami i trzymajcie wycofanie. Jeśli szukacie platformy bez narastającego rachunku za każdą VM, Proxmox VE zasługuje na pilotaż w Waszym racku - z metrykami, nie z hasłami.
Przed pierwszą falą spiszcie trzy liczby: średnie i szczytowe vCPU na godzinę, RAM z uwzględnieniem mechanizmu balloon oraz opóźnienie dysku pod typowym obciążeniem. Dołóżcie mapę DNS i VIP. Bez tych danych „klaster gotowy” oznacza tylko, że panel się otwiera. W DC to za mało.
Zaplanujcie wyłączenie starego środowiska: data przeglądu i kryteria (zero krytycznych VM na starym hiperwizorze, backup zweryfikowany, monitoring zielony przez 72 godziny). Dopóki stare hosty stoją „na wszelki wypadek”, płacicie podwójnie - prądem, miejscem w racku i uwagą ludzi.
Zestawcie koszty trzech lat: licencje i wsparcie starego stosu wobec sprzętu, wsparcia i ludzi przy nowym. Wyraźna różnica i udany pilotaż czynią decyzję inżynierską. Po każdej fali usuwajcie tymczasowe mosty, reguły i skrypty „na weekend”.
Artykuł Partnera